Aula 08 - Melhoria contínua orientada por dados e síntese do ciclo de desenvolvimento
- Objetivos: Explorar melhoria contínua por meio de dados e síntese do ciclo de desenvolvimento.
- Curso: CST em Análise e Desenvolvimento de Sistemas
- Série: 4º Semestre
- Disciplina: Gerenciamento de Projetos Ágil
8.1 Revisões e retrospectivas baseadas em dados
8.1.1 Por que decisões orientadas por dados nas cerimônias
- Reduzem viés de percepção, tornando a discussão objetiva.
- Aceleram o aprendizado, permitindo comparar hipóteses x resultados.
- Conectam entregas a resultados de produto (outcomes) e não apenas a saídas (outputs).
- Alimentam previsibilidade e transparência com a liderança e stakeholders.
- Promovem segurança psicológica ao deslocar o foco do indivíduo para o sistema de trabalho.
8.1.2 Métricas essenciais e quando usá-las
- Lead time de alteração: tempo do pedido ao valor em produção; orienta tempo de resposta do produto.
- Cycle time: tempo em desenvolvimento; orienta eficiência interna e gargalos.
- Throughput: itens concluídos por intervalo; apoia previsão e capacidade.
- WIP e políticas de fluxo: limitam trabalho simultâneo e aumentam foco.
- Flow efficiency: proporção de tempo em trabalho ativo; indica esperas ocultas.
- Percentil 85/90 do lead/cycle time: base para compromissos realistas.
- Defeitos escapados e taxa de retrabalho: saúde da qualidade.
- DORA (frequência de deploy, lead time de mudança, taxa de falha de mudança, MTTR): maturidade DevOps.
- Satisfação do usuário (NPS/CSAT) e adoção: confirmação de valor entregue.
Observação: métricas informam, não culpabilizam. Use-as para ajustar o sistema, não as pessoas.
8.1.3 Fontes de dados e integração leve
- Gestão de trabalho: Jira/Azure Boards (status, tempos, etiquetas, épicos).
- Controle de versão: Git (commits, PRs, branches, lead time de PR).
- CI/CD: pipelines, tempos de build/teste/deploy, aprovações.
- Observabilidade/Operações: logs, incidentes, SLO/SLI, tempo de restauração.
- Produto: analytics (eventos, funis), feedback de usuários e suporte.
Boas práticas:
- Definir convenções de nomes e estados (DoR/DoD) para padronizar coleta.
- Versionar definições de métricas e painéis.
- Anonimizar dados pessoais e sensíveis.
8.1.4 Preparação do review: evidências de valor
- Relacione incremento às metas (OKRs/KPIs) do produto.
- Mostre critérios de aceite atendidos, com evidências de testes e uso.
- Apresente indicadores de adoção/uso quando disponíveis.
- Registre dúvidas, riscos e decisões para rastreabilidade.
Checklist enxuto do review:
- O que foi entregue e para quem gerou valor.
- Comportamento esperado x medido (métrica alvo).
- Próximas hipóteses/ajustes derivados da evidência.
8.1.5 Preparação da retrospectiva: diagnóstico do fluxo
- Coletar métricas do intervalo (lead/cycle time, throughput, WIP, defeitos, DORA).
- Visualizar distribuição (boxplot/histograma) e percentis para detectar caudas longas.
- Identificar filas, reentradas e esperas por dependências.
- Levantar mudanças de contexto (feriados, incidentes, ausências, refatorações, auditorias).
Questões norteadoras:
- O que mudou no sistema que explica os sinais?
- Que políticas ou acordos falharam/emergiram?
- Quais hipóteses testamos e o que aprendemos?
8.1.6 Facilitação baseada em dados
- Abrir com objetivos da iteração e uma visão rápida do painel.
- “Story behind the curve”: selecionar 1–2 anomalias e contar a história sistêmica.
- Priorização por impacto x esforço (Matriz ICE/WSJF simplificado).
- Gerar experimentos de melhoria com hipótese explícita, métrica e guardrails.
- Converter ações em itens do backlog com DoR claro e limites de WIP.
Modelo de experimento (PDSA):
- Hipótese: Se fizermos X, então Y melhorará, medido por M, de B para T.
- Plano: mudar política/automação/definição/treinamento.
- Execução: aplicar por N ciclos.
- Estudo: comparar base x novo resultado.
- Ação: padronizar, ajustar ou descartar.
8.1.7 Antipadrões e cuidados
- Lei de Goodhart: quando uma métrica vira meta, deixa de ser boa métrica.
- Métricas de vaidade: linhas de código, pontos por pessoa.
- Médias sem variabilidade: prefira percentis e distribuições.
- Correlação ≠ causalidade: experimente com controle quando possível.
- Amostras pequenas: acumule evidência ao longo de ciclos.
- Privacidade e conformidade: anonimização e minimização de dados.
8.1.8 Painel mínimo para review e retro
- Entregas: lista de itens Done com link e critério de aceite.
- Fluxo: lead/cycle time (p50/p85), throughput por semana, WIP médio.
- Qualidade: defeitos abertos x fechados, taxa de retrabalho.
- DevOps: frequência de deploy, tempo médio de PR, taxa de falha de mudança, MTTR.
- Produto: métrica de adoção/uso do incremento (quando aplicável).
Diagrama do circuito de melhoria contínua: 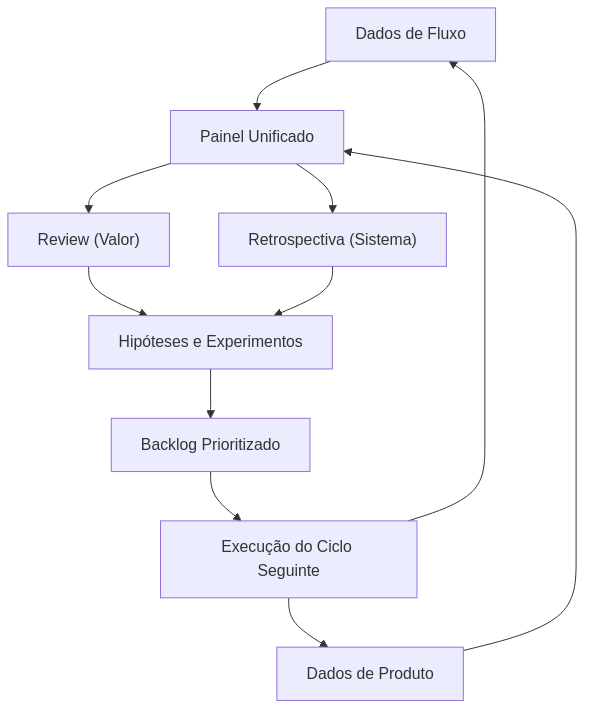
8.2 Síntese do ciclo de desenvolvimento
8.2.1 Visão ponta a ponta do fluxo de valor
- Do insight ao impacto: da descoberta à medição de resultado em produção.
- Integração entre produto, engenharia, qualidade, operações e conformidade.
- Cadências que se reforçam: planejamento, execução, revisão, aprendizado.
Diagrama do ciclo de desenvolvimento: 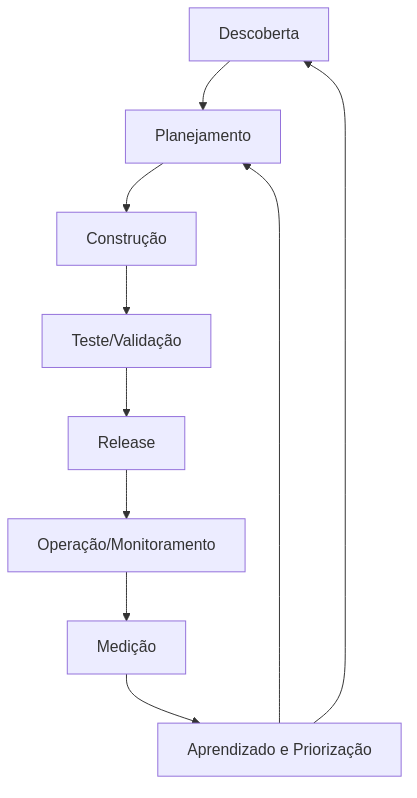
8.2.2 Artefatos e políticas que conectam o ciclo
- Visão de produto e objetivos mensuráveis (OKRs, metas SMART).
- Backlog com critérios de aceite claros e fatiamento por valor.
- Políticas de fluxo: DoR/DoD, limites de WIP, acordos de PR e testes.
- Qualidade e segurança como parte do DoD (testes automatizados, SAST/DAST, revisão de privacidade).
- Observabilidade desde o design: logs estruturados, métricas e traços.
- Planejamento de releases com janelas, feature flags e rollback.
- Conformidade leve: registro de decisões, rastreabilidade, revisão de dados pessoais.
8.2.3 Mapeamento do fluxo e identificação de gargalos
- Mapear etapas, filas e tempos de espera (Value Stream Mapping).
- Quantificar trabalho interrompido, reentradas e dependências externas.
- Enxergar dispersão (variância) além de médias para priorizar melhorias.
- Contramedidas típicas:
- Reduzir tamanho de lote (histórias menores, PRs menores).
- Limitar trabalho em paralelo (WIP).
- Automatizar validações repetitivas (CI, testes).
- Tornar políticas explícitas e visíveis (quadros, checklists).
8.2.4 Loops de feedback e previsibilidade
- Feedback rápido de código (CI), de uso (analytics) e de negócio (métricas de produto).
- Previsibilidade baseada em throughput histórico e percentis de ciclo.
- Incorporar incidentes e débitos técnicos ao backlog com capacidade reservada.
- Evitar sobrecarga de cerimônias: foco em decisões e aprendizados.
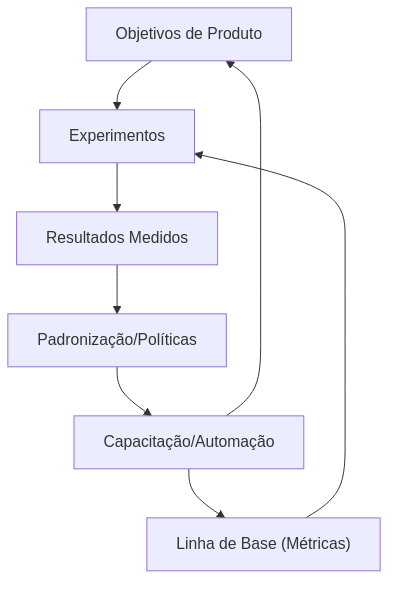
8.2.5 Roteiro de melhoria contínua
- Descobrir: levantar dores e hipóteses priorizadas por impacto.
- Medir: estabelecer linha de base e métricas de guarda.
- Experimentar: pequenas mudanças reversíveis com feature flags.
- Aprender: comparar resultados, padronizar o que funcionou.
- Escalar: compartilhar práticas, atualizar políticas e automações.
Diagrama de alinhamento entre metas, fluxo e aprendizagem:
8.2.6 Estudo de caso resumido
Contexto:
- Produto de e-commerce observou aumento no tempo de checkout e queda de conversão.
- Métricas mostraram crescimento do lead time e aumento do MTTR após incidentes.
Hipótese:
- Grandes PRs e ausência de testes de carga elevam o risco e o tempo de recuperação.
Experimentos:
- Limite de PR a 300 linhas alteradas e obrigatoriedade de testes de carga para checkout.
- Adoção de feature flags para liberar em fatias.
Resultados:
- Queda de 28% no lead time (p85) e redução de MTTR de 2,1 para 0,9 ciclos.
- Conversão de checkout recuperada em 12% relativo.
Exemplo de regra de CI para gatilho de teste de carga:
# .gitlab-ci.yml (exemplo)
stages: [build, test, performance, deploy]

performance_test:
  stage: performance
  rules:
    - if: '$CI_MERGE_REQUEST_CHANGED_LINES > 300 || $AFFECTS_AREA == "checkout"'
  script:
    - k6 run tests/perf/checkout.js
  artifacts:
    when: always
    paths:
      - reports/perf/checkout-summary.json
Exemplo de evento de analytics para medir adoção do incremento:
{
  "event": "checkout_step_view",
  "step": "payment",
  "user_anonymous_id": "a3f1...e9",
  "feature_flag": "new-checkout",
  "timestamp": "2026-10-06T12:34:56Z"
}
8.2.7 Checklist de integração do ciclo
- Visão e metas atualizadas e visíveis.
- Backlog fatiado por valor com DoR/DoD explícitos.
- Pipeline com testes, segurança e inspeções automatizadas.
- Observabilidade ativa e SLOs definidos.
- Painel unificado de fluxo, qualidade, DevOps e produto.
- Cadência de revisão/retro com decisões registradas.
- Ações de melhoria traduzidas em backlog e políticas.
Conclusão
A melhoria contínua orientada por dados conecta o que a equipe entrega ao impacto percebido pelo usuário e pelo negócio. Ao incorporar métricas confiáveis no review e na retrospectiva, o time aprende mais rápido, identifica gargalos do sistema e executa experimentos de pequeno risco que elevam qualidade, previsibilidade e valor. A síntese do ciclo de desenvolvimento integra políticas, automações e feedbacks em um fluxo coeso, do insight à medição de resultados, sustentando evolução técnica e de produto.
Próxima aula
Revisão prática de visão de produto e backlog com foco em objetivos mensuráveis e critérios de aceite, reforçando a conexão entre metas, valor entregue e planejamento das próximas iterações.