Aula 06 - Dependências, Vulnerabilidades e Gerenciamento de Incidentes
- Objetivos: Abordar dependências, vulnerabilidades e incidentes, fortalecendo a confiabilidade operacional.
- Curso: CST em Análise e Desenvolvimento de Sistemas
- Série: 4º período (semestral)
- Disciplina: Gerenciamento de Projetos Ágil
Visão geral da aula
Nesta aula, conectamos a gestão de dependências e vulnerabilidades à operação e ao gerenciamento de incidentes. O objetivo é reduzir riscos de cadeia de suprimentos de software, elevar o padrão de qualidade e criar respostas eficazes a incidentes, mantendo a continuidade do serviço e a confiança do usuário.
Fundamentos de confiabilidade operacional
- Confiabilidade como propriedade emergente: resulta de escolhas em arquitetura, automação, testes, observabilidade e resposta a incidentes.
- Cadeia de suprimentos de software: bibliotecas, imagens de contêiner, ferramentas de build, pipelines e infraestrutura como código.
- Princípios orientadores:
- Prevenção > Detecção > Resposta > Aprendizado contínuo.
- Automação segura por padrão (secure-by-default) e mínima superfície de ataque.
- Transparência e rastreabilidade (SBOM, auditorias de build, assinaturas).
6.1 Dependências e vulnerabilidades
Tipos de dependências e seus riscos
- Dependências diretas e transitivas: vulnerabilidades frequentemente entram por transitivas.
- Ambientes e escopos: runtime vs. desenvolvimento; produção vs. teste.
- Imagens base e runtimes: SO, contêineres, VMs, funções serverless.
Versionamento e reprodutibilidade
- Versionamento semântico (SemVer): MAJOR.MINOR.PATCH.
- Faixas de versão:
- Fixa (pinning) aumenta reprodutibilidade.
- Caret/til (~, ^) acelera updates, mas amplia superfície de risco.
- Lockfiles e hashes: garantem integridade de resolução de dependências.
Exemplo (Node.js) com política de versões e lockfile:
{
  "name": "app-segura",
  "version": "1.0.0",
  "private": true,
  "dependencies": {
    "express": "4.19.2",         // versão fixa para reprodutibilidade
    "pino": "^9.0.0"             // caret para obter correções rápidas (avaliar risco)
  },
  "devDependencies": {
    "eslint": "~9.9.0"           // til para fixar minor e permitir patch
  },
  "engines": {
    "node": ">=20.11.0"
  }
}
Python com pinning e verificação por hash:
# requirements.txt
flask==3.0.3 --hash=sha256:aaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaa
gunicorn==22.0.0 --hash=sha256:bbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbb
SBOM (Software Bill of Materials)
- O que é: manifesto de componentes, versões, licenças e origem.
- Padrões comuns: CycloneDX, SPDX.
- Benefícios: triagem acelerada em incidentes, conformidade, gestão de risco.
Gerando SBOM (CycloneDX para Node.js):
npm install --save-dev @cyclonedx/cyclonedx-npm
npx @cyclonedx/cyclonedx-npm --output-format json --output-file sbom.json
Vulnerabilidades: identificação e classificação
- Bases e padrões: CVE, CVSS (Base/Temporal/Environmental).
- Severidade vs. explorabilidade vs. exposição:
- Severidade CVSS não é risco; risco = severidade × probabilidade × impacto × exposição.
- Contexto: recurso exposto à internet? há autenticação? dados sensíveis?
Triagem orientada a risco: - Inventário afetado (via SBOM). - Exploit conhecido (KEV/CISA) e compensações ativas (WAF, feature flags). - Janela de manutenção e impacto no usuário.
Ferramentas e automação de varredura
Varreduras complementares: - SCA (Software Composition Analysis) para bibliotecas e imagens. - SAST/DAST para código e comportamento em runtime. - Scan de IaC e segredos.
Pipeline exemplo (GitHub Actions) com SCA e scan de contêiner:
name: security-pipeline

on:
  pull_request:
  push:
    branches: [ "main" ]

jobs:
  sca:
    runs-on: ubuntu-latest
    steps:
      - uses: actions/checkout@v4
      - uses: actions/setup-node@v4
        with:
          node-version: "20"
      - run: npm ci
      - name: Dependency Review
        uses: actions/dependency-review-action@v4
  container_scan:
    runs-on: ubuntu-latest
    steps:
      - uses: actions/checkout@v4
      - name: Build image
        run: docker build -t app:ci .
      - name: Trivy Scan
        uses: aquasecurity/trivy-action@0.20.0
        with:
          image-ref: app:ci
          format: 'table'
          vuln-type: 'os,library'
          severity: 'CRITICAL,HIGH'
          ignore-unfixed: true
Scan de IaC (Terraform/Kubernetes) com Checkov:
pip install checkov
checkov -d infra/
Políticas de atualização e governança de dependências
- Política de janelas de atualização:
- Patches: contínuo/automático (quando seguro).
- Minor: quinzenal/mensal com smoke tests.
- Major: trimestral/semestral com plano de rollback.
- Renovation bots (ex.: Renovate) com regras de agrupamento e auto-merge de patches.
Exemplo de configuração (Renovate):
{
  "extends": ["config:recommended"],
  "rangeStrategy": "replace",
  "packageRules": [
    {
      "matchUpdateTypes": ["patch"],
      "automerge": true,
      "groupName": "patches-seguros"
    },
    {
      "matchManagers": ["npm"],
      "matchPackageNames": ["express", "pino"],
      "separateMinorPatch": true
    }
  ],
  "vulnerabilityAlerts": {
    "enabled": true
  }
}
Mitigação e correção
- Patching direto vs. hotfix/rollback.
- Workarounds: flags de recurso, bloqueio de endpoints, regras temporárias no WAF.
- Exceções temporárias com prazo e proprietário (risk acceptance timeboxed).
- Testes:
- Testes de regressão automatizados e smoke tests em canários.
- Testes de segurança: fuzzing leve em interfaces críticas.
Boas práticas em contêineres e SO
- Imagens mínimas (distroless, alpine com critério).
- Usuário não-root e drop de capabilities.
- Atualizações regulares de base image com re-scan.
- Multi-stage builds e varredura antes do push.
Exemplo de Dockerfile com healthcheck e usuário não-root:
FROM gcr.io/distroless/nodejs20:latest
WORKDIR /app
COPY --chown=nonroot:nonroot package*.json ./
COPY --chown=nonroot:nonroot dist/ ./dist/
USER nonroot
ENV NODE_ENV=production
EXPOSE 3000
CMD ["dist/server.js"]
HEALTHCHECK --interval=30s --timeout=3s --retries=3 CMD ["node", "-e", "fetch('http://127.0.0.1:3000/health').then(r=>process.exit(r.ok?0:1)).catch(()=>process.exit(1))"]
6.2 Operação e gerenciamento de incidentes
Conceitos-chave
- SLI/SLO e Orçamento de Erros:
- SLI Service Level Indicator (Indicador de Nível de Serviço): indicadores de nível de serviço (latência p95, taxa de sucesso).
- SLO Service Level Objective (Objetivo de Nível de Serviço): alvo (ex.: 99,9% sucesso mensal).
- Orçamento de erros: margem permitida para falhas → decisões de lançamento e endurecimento.
- Observabilidade:
- Logs estruturados, métricas cardinalidade controlada, traces distribuídos.
- Correlação: request-id, trace-id.
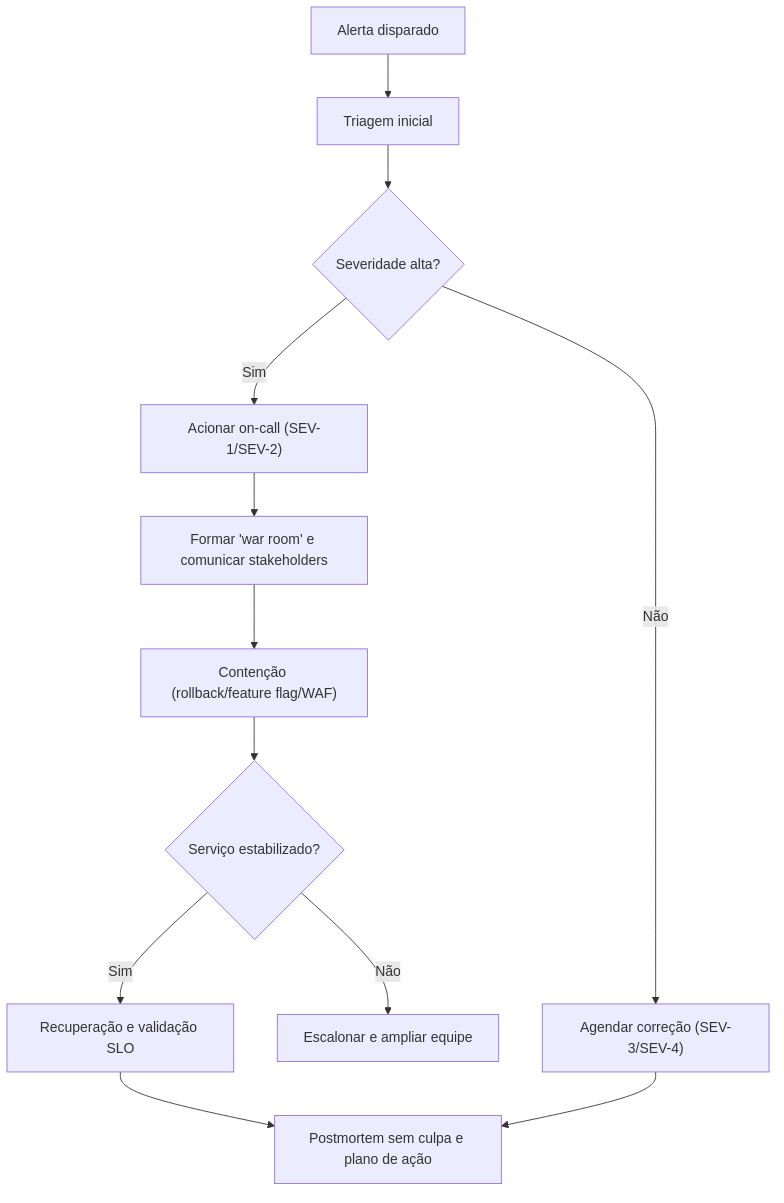
Ciclo de vida de incidentes
- Detecção: alertas confiáveis e deduplicados.
- Triagem: classificar severidade (SEV-1 a SEV-4).
- Resposta: contenção, mitigação, comunicação.
- Recuperação: restaurar serviço ao estado alvo.
- Aprendizado: pós-incidente sem culpa (blameless) e ações.
Diagrama de fluxo do incidente:
Classificação de severidade (exemplo)
- SEV-1: indisponibilidade total ou impacto crítico a segurança/dados.
- SEV-2: degradação severa com workaround limitado.
- SEV-3: impacto moderado com workaround claro.
- SEV-4: impacto baixo, sem urgência operacional.
Papéis e comunicação
- Incident Commander (coordena), Communications Lead (status), Tech Lead(s) (diagnóstico/mitigação), Scribe (linha do tempo).
- Canais e cadência:
- Interno: canal dedicado, atualização a cada 15–30 min em SEV-1/2.
- Externo: status page e comunicado objetivo.
Template de comunicado (externo): - O que ocorreu (alto nível, sem culpas). - Impacto e escopo. - Status atual e próximos passos. - Janela de tempo e canais de suporte.
Estratégias de contenção e recuperação
- Rollback atômico e versionado (blue/green, canary).
- Feature flags para desativar componentes problemáticos sem redeploy.
- Rate limiting e circuit breakers para proteger dependências.
Exemplo simples de circuit breaker (Node.js com opossum):
import CircuitBreaker from "opossum";

async function callPayment(payload) {
  const res = await fetch("https://payments/api", { method: "POST", body: JSON.stringify(payload) });
  if (!res.ok) throw new Error("payment failed");
  return res.json();
}

const breaker = new CircuitBreaker(callPayment, {
  timeout: 3000,
  errorThresholdPercentage: 50,
  resetTimeout: 10000
});

breaker.fallback(() => ({ status: "degraded", message: "Pagamento indisponível. Tente mais tarde." }));

export async function pay(payload) {
  return breaker.fire(payload);
}
Runbooks e preparação
- Runbook: passos claros para diagnosticar e mitigar classes de incidentes (latência alta, erro 5xx, fila atrasada, DB saturado).
- Pré-requisitos: alarmes com thresholds alinhados a SLO, dashboards prontos, acessos de emergência (break-glass) auditados, backups testados (RTO/RPO definidos).
Runbook (exemplo, latência alta): - Validar se a latência excede SLO por ≥5 min (p95 > 800 ms). - Checar erros 5xx, saturação de CPU, conexões DB. - Aplicar contenção: ampliar pods, ativar cache, reduzir timeouts a jusante. - Se persistir: rollback para versão estável, comunicar status. - Registrar linha do tempo e evidências para postmortem.
Pós-incidente e aprendizado
- Postmortem sem culpa:
- Linha do tempo factual.
- Análise causal (5 Porquês, diagrama de Ishikawa).
- Ações priorizadas (donos, prazos, métricas de eficácia).
- Integração ao backlog: itens de resiliência, testes, automação, dívidas operacionais.
- Medidas de sucesso: tempo de detecção (MTTD), de reconhecimento (MTTA), de mitigação (MTTM), de recuperação (MTTR), regressão de incidentes.
Integração entre segurança e operação (DevSecOps)
- Assinatura e verificação de artefatos (Sigstore/Cosign).
- Build reproduzível e cadeias verificáveis (SLSA níveis iniciais).
- Gestão de segredos: vaults, rotação, varredura de vazamentos.
- Gate de qualidade no pipeline: bloqueio por vulnerabilidades críticas sem exceção documentada.
- Auditoria leve: trilhas de quem aprovou, quando e por quê (PR templates com risco e rollback plan).
Exemplo: assinatura de imagem com Cosign
cosign generate-key-pair
cosign sign --key cosign.key registry.example.com/app:1.2.3
cosign verify --key cosign.pub registry.example.com/app:1.2.3
Estudos de caso (síntese)
- Caso A: CVE crítico em biblioteca transitiva.
- Descoberta via alerta SCA; mitigação com override/patch; rollout canário; verificação de regressão.
- Caso B: Latência elevada após release.
- Detecção por SLI; rollback imediato; ajuste de timeouts; postmortem aponta N+1 queries → ação: índice e teste de carga.
- Caso C: Segredo exposto no repositório.
- Revogação/rotação imediata; varredura histórica; políticas de pre-commit; treinamento de equipe.
Checklists úteis
Checklist de dependências - SBOM atualizado por release - Lockfile versionado e reproduzível - Renovate/Dependabot ativo e regras definidas - Varredura de imagens base e SO - Exceções de risco com owner e prazo
Checklist de incidentes - SLO/SLI definidos e visíveis - Alertas com runbooks vinculados - Rotas de escalonamento claras - Canal e template de comunicação - Postmortems publicados e acompanhados
Conclusão
Gerenciar dependências e vulnerabilidades com disciplina reduz a superfície de risco e acelera a triagem quando algo falha. Ao integrar observabilidade, SLO/SLI e um processo claro de resposta a incidentes, equipes aumentam a confiabilidade operacional e a previsibilidade de entrega. Automação, padronização (SBOM, pipelines) e aprendizado contínuo fecham o ciclo de melhoria.
Próxima aula
Planejamento de releases e conformidade: estratégias de versionamento e janelas de lançamento, rastreabilidade leve, auditoria de mudanças e fundamentos de LGPD aplicados ao ciclo de vida do produto.