Aula: 4 - Fluxo e risco: métricas e gestão
- Objetivos: Compreender e aplicar métricas de fluxo para aumentar previsibilidade e eficiência; estruturar a gestão de riscos em ambientes ágeis com foco em identificação, análise, resposta e monitoramento contínuo.
- Curso: CST em Análise e Desenvolvimento de Sistemas
- Série: 4º semestre
- Disciplina: Gerenciamento de Projetos Ágil
1. Introdução
Nesta aula, aprofundamos duas frentes essenciais para entregar valor com regularidade e segurança: métricas de fluxo (para enxergar e otimizar o trabalho em andamento) e gestão de riscos (para reduzir incertezas técnicas, de produto e operacionais).
Vamos conectar dados de fluxo a decisões práticas de capacidade, políticas de trabalho e previsibilidade, além de incorporar riscos ao backlog e às rotinas do time.
2. Métricas de fluxo
2.1 Conceitos fundamentais
| Métrica | Definição | Perspectiva |
|---|---|---|
| WIP (Work in Progress) | Quantidade de itens atualmente em execução | Sistema de trabalho |
| Lead Time | Tempo entre a solicitação e a entrega | Cliente |
| Cycle Time | Tempo entre o início do trabalho ativo e a entrega | Equipe |
| Throughput | Quantidade de itens concluídos por unidade de tempo | Sistema |
| Work Item Age | Tempo que um item em andamento permanece no WIP | Item |
| Eficiência de fluxo | Proporção entre tempo efetivamente trabalhado e tempo total | Processo |
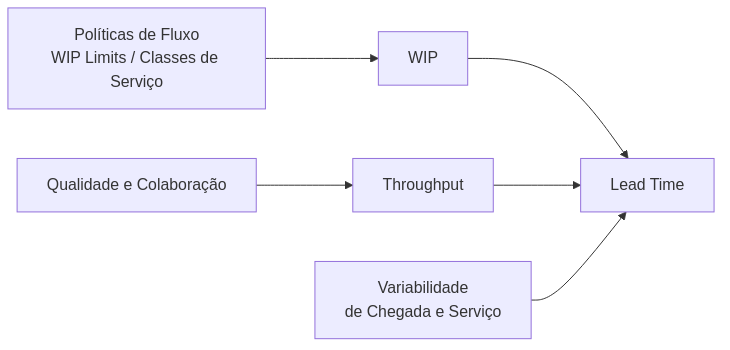
Lei de Little
Uma relação fundamental entre as métricas de fluxo é:
Lead Time ≈ WIP / Throughput
A implicação prática é importante:
- Para reduzir o lead time, podemos reduzir o WIP.
- Podemos aumentar o throughput.
- Podemos atuar nas duas variáveis simultaneamente.
2.2 Coleta de dados de fluxo
As principais fontes de dados são:
- Quadros Kanban e Scrum.
- Issue trackers.
- Sistemas de gerenciamento de projetos.
- Histórico de movimentação dos itens entre os estágios do fluxo.
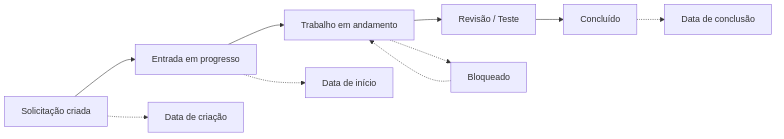
Para cada item, é importante registrar pelo menos:
| Evento | Descrição |
|---|---|
| Criação | Momento em que a solicitação entrou no sistema |
| Entrada em progresso | Momento em que o trabalho efetivamente começou |
| Conclusão | Momento em que o item foi entregue |
| Bloqueio | Momento em que o trabalho ficou impedido |
| Desbloqueio | Momento em que o trabalho pôde continuar |
O fluxo de coleta pode ser representado da seguinte forma:
Para garantir dados confiáveis:
- Padronize os estágios do fluxo.
- Defina claramente quando um item entra e sai de cada estágio.
- Evite movimentações artificiais.
- Registre bloqueios explicitamente.
- Não mova itens apenas para alterar indicadores.
- Evite retornar itens para colunas anteriores sem uma justificativa real.
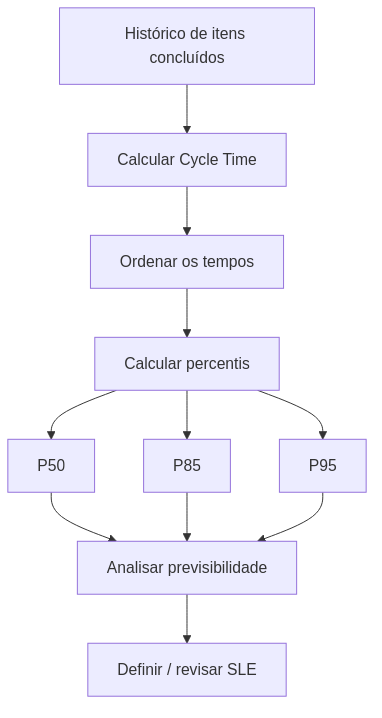
2.3 Análise prática: percentis e previsibilidade
O uso de médias isoladamente pode esconder uma grande variabilidade.
Por isso, percentis são mais adequados para representar previsibilidade.
| Percentil | Interpretação |
|---|---|
| P50 | 50% dos itens são concluídos nesse tempo ou menos |
| P70 | 70% dos itens são concluídos nesse tempo ou menos |
| P85 | 85% dos itens são concluídos nesse tempo ou menos |
| P95 | 95% dos itens são concluídos nesse tempo ou menos |
Exemplo:
P85 = 8 dias úteis
Significa que aproximadamente 85% dos itens foram concluídos em até 8 dias úteis no período analisado.
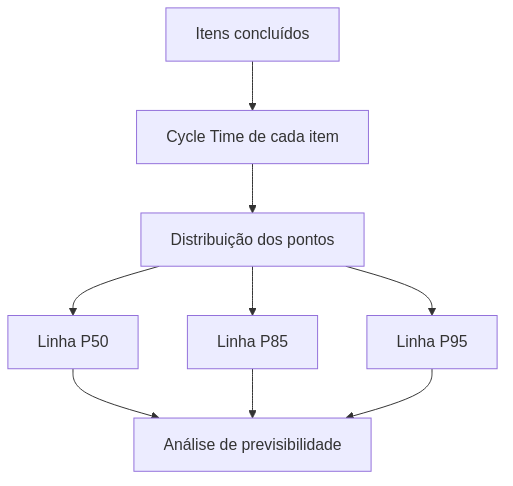
A análise pode seguir este fluxo:
SLE — Service Level Expectation
A SLE é uma expectativa baseada em dados históricos.
Exemplo:
| Indicador | Valor |
|---|---|
| P50 | 4 dias |
| P85 | 8 dias |
| P95 | 12 dias |
| SLE | 8 dias |
Nesse caso, a equipe poderia comunicar:
“Esperamos que aproximadamente 85% dos itens sejam concluídos em até 8 dias úteis.”
A SLE deve ser revisada periodicamente, preferencialmente utilizando dados recentes.
2.4 Visualizações: CFD, Scatterplot e Aging WIP
Cumulative Flow Diagram — CFD
O CFD mostra a quantidade de trabalho existente em cada estágio ao longo do tempo.
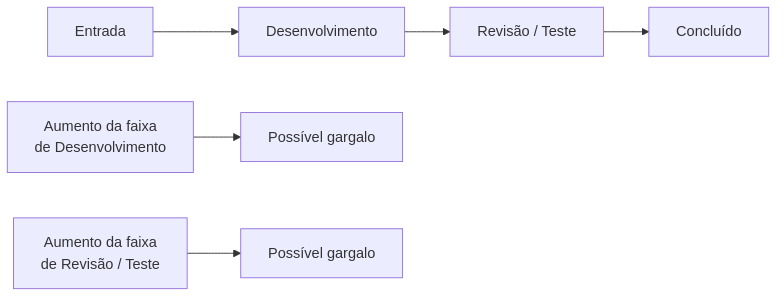
No CFD:
- Faixas que aumentam rapidamente podem indicar acúmulo.
- Uma faixa de trabalho em progresso crescendo continuamente pode indicar WIP excessivo.
- Uma faixa de revisão/teste aumentando pode indicar gargalo nessa etapa.
- A distância entre entrada e saída representa o tempo necessário para atravessar o sistema.
Scatterplot
O scatterplot relaciona cada item concluído ao seu respectivo cycle time.
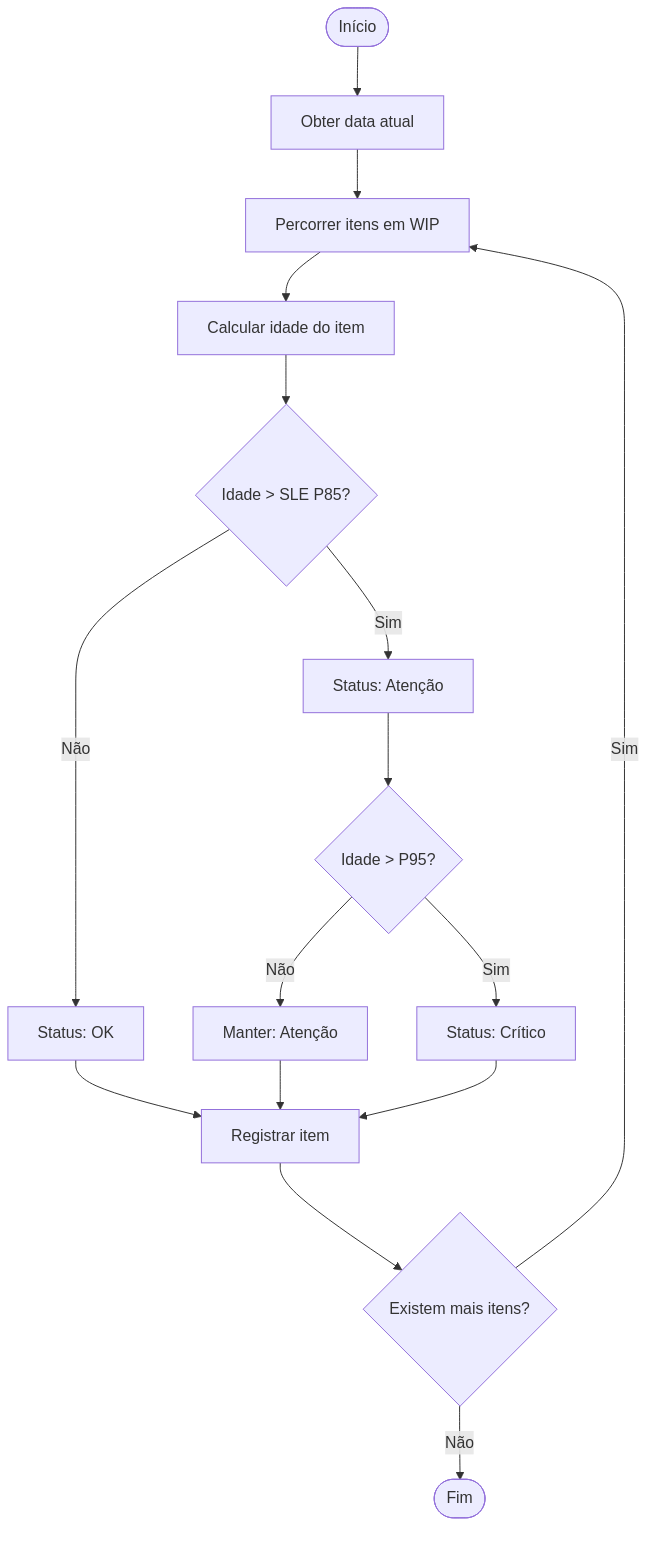
Aging WIP
O Aging WIP monitora há quanto tempo os itens atualmente em andamento permanecem no sistema.
| Situação | Interpretação |
|---|---|
| Idade abaixo da SLE | Situação normal |
| Idade próxima da SLE | Atenção |
| Idade acima da SLE | Investigar |
| Idade acima do P95 | Situação crítica |
A prioridade deve ser terminar itens antigos antes de iniciar trabalho adicional.
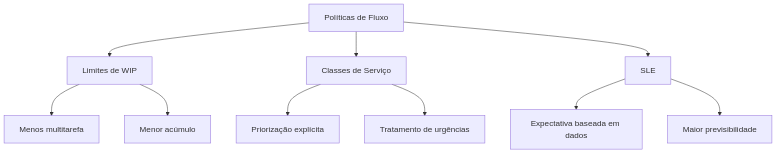
2.5 Políticas de fluxo: WIP, classes de serviço e SLE
Limites de WIP
Os limites de WIP reduzem multitarefa e ajudam a diminuir o tempo de atravessamento do sistema.
| Coluna | Limite WIP | Política |
|---|---|---|
| Triagem | 10 | Aceitar somente itens com objetivo e critérios de aceite claros |
| Em Progresso | 6 | Trabalho focado; evitar puxar novos itens quando houver itens envelhecendo |
| Revisão/Teste | 4 | Não mover sem evidência de testes; bloqueios visíveis |
| Concluído | — | Sem limite operacional |
Classes de serviço
| Classe | Característica | Tratamento |
|---|---|---|
| Expedição | Urgente | Pode interromper a fila; exige capacidade reservada |
| Padrão | Trabalho normal | Segue a fila e os limites de WIP |
| Data Fixa | Possui prazo obrigatório | Deve ser priorizado para cumprir o compromisso |
| Intangível | Dívida técnica ou risco futuro | Deve receber capacidade protegida |
O relacionamento entre as políticas pode ser representado assim:
2.6 Ações de melhoria guiadas por dados
| Observação | Possível causa | Ação |
|---|---|---|
| WIP alto + Lead Time crescente | Trabalho demais iniciado | Parar de puxar novos itens |
| Throughput caiu | Bloqueios ou problemas de qualidade | Investigar gargalos |
| Muitos itens envelhecendo | Dependências ou itens grandes | Quebrar itens e remover dependências |
| Revisão/Teste acumulando | Gargalo de qualidade | Pairing, swarming e automação |
| Muitos retornos de itens | Qualidade insuficiente | Melhorar critérios de aceite e testes |
O processo de decisão deve ser orientado pelos dados:
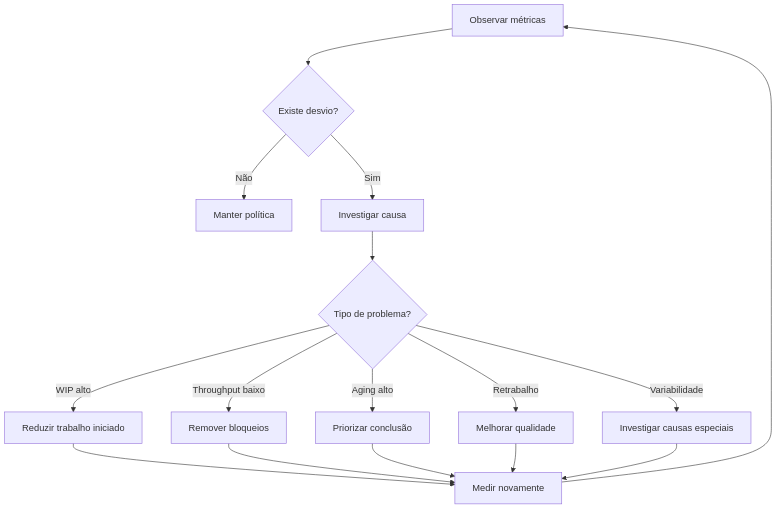
Use gráficos de controle para distinguir:
- Variação comum: comportamento esperado do sistema.
- Variação especial: evento incomum que merece investigação específica.
2.7 Estudo de caso resumido
Contexto:
Um time apresenta:
| Indicador | Situação |
|---|---|
| P85 de Cycle Time | 14 dias |
| WIP médio | 18 itens |
| Throughput | 8 itens/semana |
Pela Lei de Little:
Lead Time ≈ 18 / 8 = 2,25 semanas
Isso corresponde aproximadamente a 11 dias úteis.
Entretanto, o P85 observado é de 14 dias.
A diferença indica que a variabilidade e os bloqueios estão afetando o fluxo.
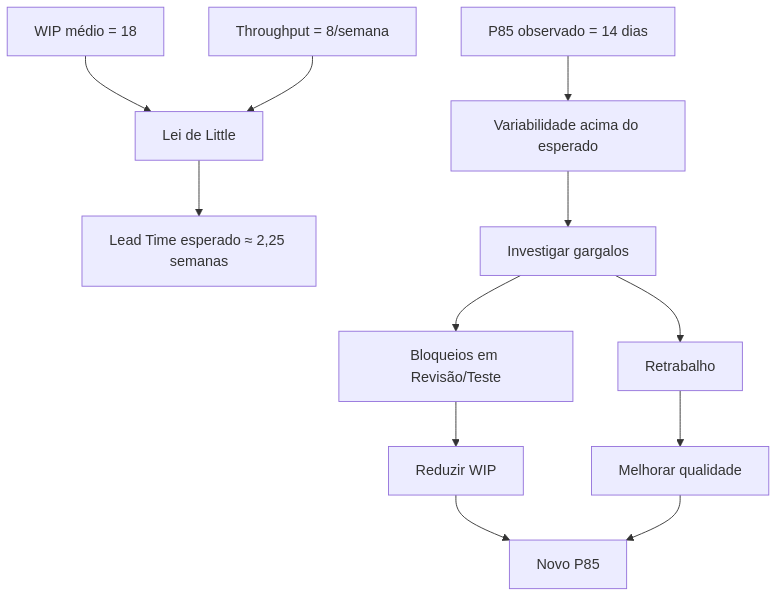
Intervenções:
- Limitar WIP de Revisão/Teste para 3.
- Adotar a política “terminar antes de começar”.
- Fazer pareamento entre desenvolvimento e QA.
- Automatizar testes básicos.
Resultado após quatro semanas:
| Indicador | Antes | Depois |
|---|---|---|
| P85 | 14 dias | 9 dias |
| Throughput | 8/semana | 8–9/semana |
2.8 Exercício prático
Utilizando dados do quadro da equipe dos últimos 90 dias:
- Calcule P50 e P85 de cycle time.
- Defina uma SLE.
- Identifique três itens que estão envelhecendo acima da SLE.
- Proponha ações para finalizá-los.
- Simule o impacto de reduzir o WIP em 20%.
3. Gestão de riscos
3.1 Conceitos e princípios
Risco é um evento incerto que pode produzir efeito positivo ou negativo sobre os objetivos.
| Categoria | Exemplos |
|---|---|
| Entrega / Cronograma | Dependências, indisponibilidade |
| Produto / Mercado | Hipótese de valor incorreta |
| Técnico / Qualidade | Dívida técnica, integrações |
| Segurança / Conformidade | LGPD, vulnerabilidades |
| Operacional | Incidentes, SLO/SLA |
Em ambientes ágeis, a gestão de riscos deve ser:
- Leve.
- Contínua.
- Integrada ao fluxo.
- Visível.
- Baseada em evidências.
- Conectada ao backlog e aos ritos da equipe.
3.2 Identificação: pre-mortem e sinais de alerta
Pre-mortem
O pre-mortem parte de uma situação hipotética:
“Imagine que o projeto terminou e falhou completamente. O que aconteceu?”
A equipe então trabalha de trás para frente para identificar possíveis causas.

Sinais de alerta
| Sinal | Possível risco |
|---|---|
| Itens muito grandes | Baixa previsibilidade |
| Itens ambíguos | Retrabalho |
| Poucas spikes técnicas | Incerteza técnica |
| Muitos bloqueios | Dependências não tratadas |
| Muitas reaberturas | Problemas de qualidade |
| Dependências externas sem data | Risco de cronograma |
| Dados pessoais sem base legal clara | Risco de conformidade |
| Mudanças frequentes de escopo | Instabilidade de produto |
3.3 Avaliação: probabilidade, impacto e ROAM
Uma forma simples de priorizar riscos é utilizar uma matriz de probabilidade e impacto.
| Probabilidade | Impacto | Prioridade |
|---|---|---|
| Baixa | Baixo | Baixa |
| Baixa | Alto | Média |
| Média | Baixo | Média |
| Média | Alto | Alta |
| Alta | Baixo | Média |
| Alta | Alto | Crítica |
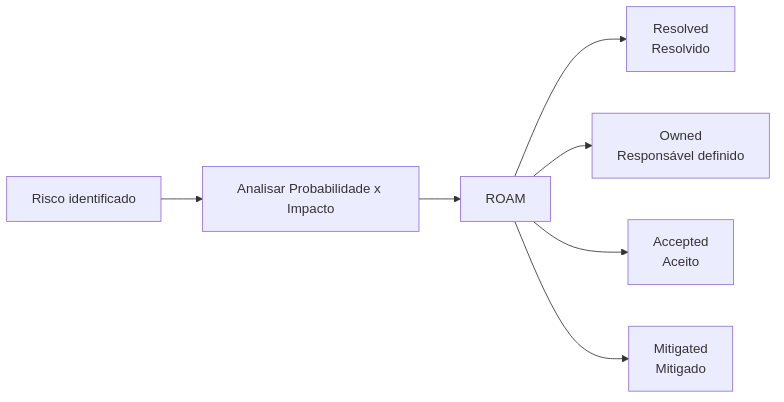
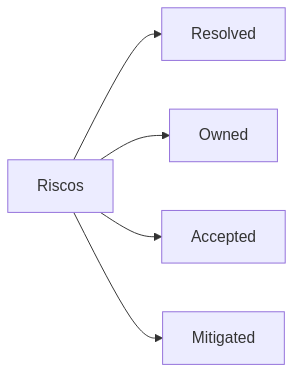
ROAM
ROAM oferece uma forma simples de definir o tratamento de cada risco.
| Status | Significado | Pergunta |
|---|---|---|
| Resolved | Resolvido | O risco deixou de existir? |
| Owned | Possui responsável | Quem irá acompanhar? |
| Accepted | Aceito | Decidimos conviver com o risco? |
| Mitigated | Mitigado | Reduzimos sua probabilidade ou impacto? |
FMEA simplificado
Para riscos técnicos, pode-se utilizar:
- S — Severidade: gravidade do impacto.
- O — Ocorrência: probabilidade de acontecer.
- D — Detecção: dificuldade de detectar o problema.
O número de prioridade do risco pode ser obtido pela combinação desses fatores:
RPN = S × O × D
| Risco | Severidade | Ocorrência | Detecção | RPN |
|---|---|---|---|---|
| A | 5 | 4 | 4 | 80 |
| B | 4 | 3 | 2 | 24 |
| C | 3 | 2 | 3 | 18 |
Quanto maior o RPN, maior a prioridade de investigação ou mitigação.
3.4 Planejamento de respostas
Riscos negativos
| Estratégia | Descrição |
|---|---|
| Evitar | Alterar o plano para eliminar o risco |
| Mitigar | Reduzir probabilidade ou impacto |
| Transferir | Transferir parte do risco para outra parte |
| Aceitar | Reconhecer o risco sem ação preventiva significativa |
Riscos positivos
| Estratégia | Descrição |
|---|---|
| Explorar | Garantir que a oportunidade aconteça |
| Aprimorar | Aumentar a probabilidade ou impacto positivo |
| Compartilhar | Trabalhar com outra parte para capturar a oportunidade |
| Aceitar | Aproveitar a oportunidade caso ela aconteça |
Todo risco relevante deve possuir:
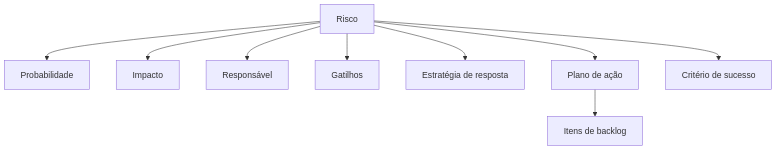
Exemplo de registro de risco
| Campo | Exemplo |
|---|---|
| ID | R-023 |
| Título | Vazamento de dados pessoais em logs |
| Categoria | Segurança / LGPD |
| Probabilidade | Alta |
| Impacto | Alto |
| ROAM | Owned |
| Responsável | Líder de Plataforma |
| Gatilhos | Alertas de PII em logs; aumento de erros 5xx |
| Resposta | Mitigar |
| Critério de sucesso | Zero PII detectado em quatro semanas |
Plano de mitigação
| Ação | Objetivo |
|---|---|
| Ativar mascaramento de PII | Evitar exposição |
| Definir retenção de logs | Reduzir exposição temporal |
| Executar varredura automatizada | Detectar vazamentos |
As contramedidas devem ser transformadas em itens rastreáveis do backlog quando exigirem trabalho.
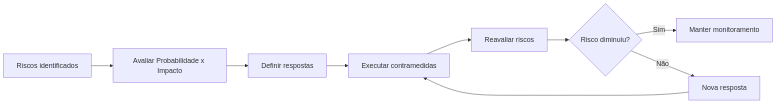
3.5 Monitoramento: risk burndown e cadência
O risk burndown acompanha a evolução do risco ao longo do tempo.
Cadência
| Momento | Atividade |
|---|---|
| Planejamento | Identificar e planejar respostas aos riscos |
| Daily | Verificar gatilhos e bloqueios críticos |
| Review | Avaliar riscos relacionados ao produto |
| Retrospectiva | Avaliar eficácia das respostas |
| Revisão periódica | Atualizar classificação e ROAM |
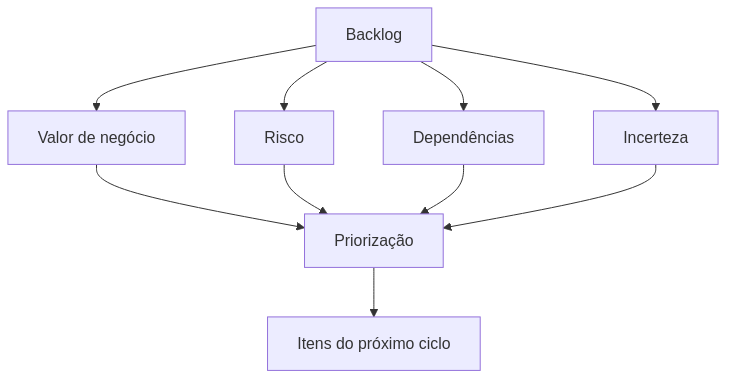
3.6 Integração ao fluxo ágil: backlog ajustado a risco
O backlog deve considerar não apenas valor de negócio, mas também redução de incerteza e risco.
Exemplos:
- Spikes técnicas.
- Provas de conceito.
- Testes de integração.
- Automação de segurança.
- Testes de contrato.
- Investigação de dependências.
Definition of Ready — DoR
Um item está pronto para ser trabalhado quando apresenta, no mínimo:
| Critério | Pergunta |
|---|---|
| Objetivo | Sabemos por que esse item existe? |
| Critérios de aceite | Sabemos quando ele estará correto? |
| Dependências | Sabemos do que ele depende? |
| Riscos | Os principais riscos foram identificados? |
| Responsabilidade | Sabemos quem acompanha os riscos relevantes? |
| Testes | Existe uma estratégia mínima de validação? |
Definition of Done — DoD
| Critério | Evidência |
|---|---|
| Critérios de aceite | Verificados |
| Testes automatizados | Executados com sucesso |
| Segurança | Verificações mínimas realizadas |
| Qualidade | Evidências disponíveis |
| Documentação | Atualizada quando necessária |
| Métricas | Atualizadas quando aplicável |
| Riscos | Registro atualizado quando necessário |
3.7 Segurança e conformidade — LGPD no ciclo
A segurança e a privacidade devem fazer parte do processo de desenvolvimento, e não ser tratadas somente no final.
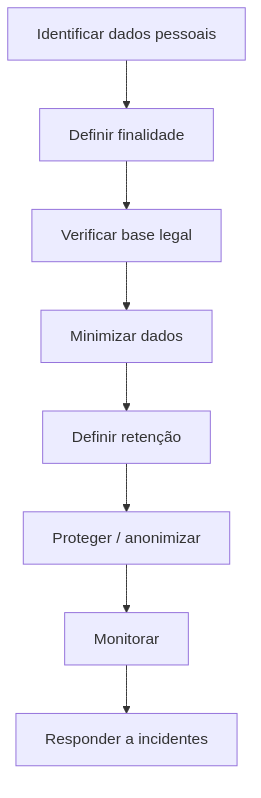
Práticas importantes:
- Mapear dados pessoais tratados.
- Identificar finalidade e base legal.
- Minimizar coleta e retenção.
- Aplicar anonimização ou pseudonimização quando possível.
- Integrar verificações de segurança às pipelines.
- Realizar SAST e DAST quando aplicável.
- Monitorar exposição de informações sensíveis.
- Manter procedimentos para atendimento aos direitos dos titulares.
- Possuir plano de resposta a incidentes.
3.8 Ferramentas e artefatos
| Artefato | Finalidade |
|---|---|
| Registro de riscos | Manter riscos visíveis e rastreáveis |
| ROAM board | Definir tratamento dos riscos |
| Pre-mortem | Identificar riscos antecipadamente |
| Checklist | Padronizar verificações |
| Issue “Risk” | Integrar riscos ao backlog |
| Alertas de observabilidade | Detectar gatilhos operacionais |
| Risk burndown | Acompanhar redução de exposição |
3.9 Estudo de caso resumido
Contexto
Uma equipe precisa entregar uma integração com um gateway externo em seis semanas.
Riscos identificados
| Risco | Probabilidade | Impacto |
|---|---|---|
| Instabilidade do sandbox | Média | Alto |
| Mudança de contrato | Média | Médio |
| Vazamento de tokens | Baixa | Alto |
Respostas
| Risco | Estratégia | Contramedida |
|---|---|---|
| Sandbox instável | Mitigar | Spike inicial e contrato de SLA |
| Mudança de contrato | Mitigar / Transferir | Testes de contrato e acordo com fornecedor |
| Vazamento de tokens | Mitigar | Rotação de chaves e vault centralizado |
Fluxo de acompanhamento
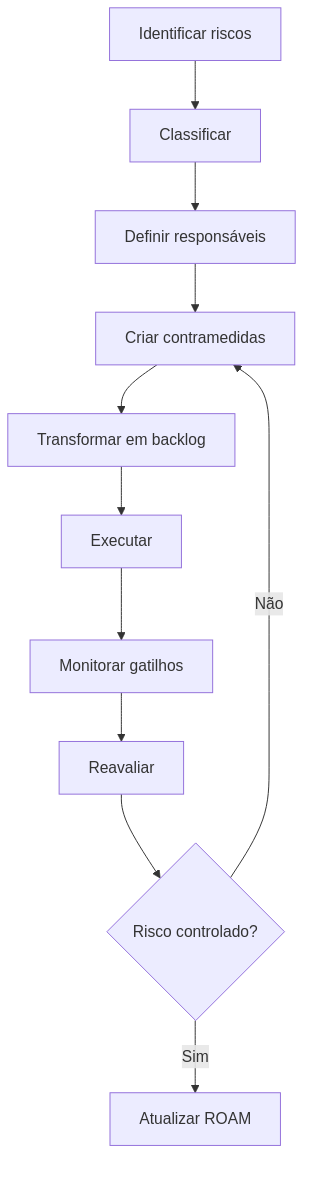
Resultado:
- A variação de escopo foi absorvida sem atraso.
- Não houve incidente de segurança.
- Os riscos foram acompanhados durante todo o ciclo.
3.10 Exercício prático
Para um épico em andamento:
- Realize um pre-mortem.
- Liste entre 8 e 10 riscos.
- Classifique cada risco por probabilidade e impacto.
- Aplique ROAM.
- Defina um responsável para cada risco relevante.
- Identifique gatilhos.
- Transforme três contramedidas em itens de backlog.
4. Previsibilidade com simulação Monte Carlo
Monte Carlo utiliza dados históricos para projetar possíveis resultados futuros considerando a variabilidade observada.
Em vez de afirmar:
“Vamos terminar em cinco semanas.”
A abordagem probabilística permite afirmar:
“Existe aproximadamente 50% de chance de terminar em até cinco semanas e 85% de chance de terminar em até sete semanas.”
Entradas e saídas
| Entrada | Descrição |
|---|---|
| Histórico de throughput | Quantidade de itens entregues por período |
| Quantidade de itens restantes | Meta que precisa ser entregue |
| Número de simulações | Quantidade de cenários simulados |
| Saída | Descrição |
|---|---|
| P50 | Cenário com aproximadamente 50% de probabilidade |
| P85 | Cenário com aproximadamente 85% de probabilidade |
| P95 | Cenário com aproximadamente 95% de probabilidade |
Processo da simulação
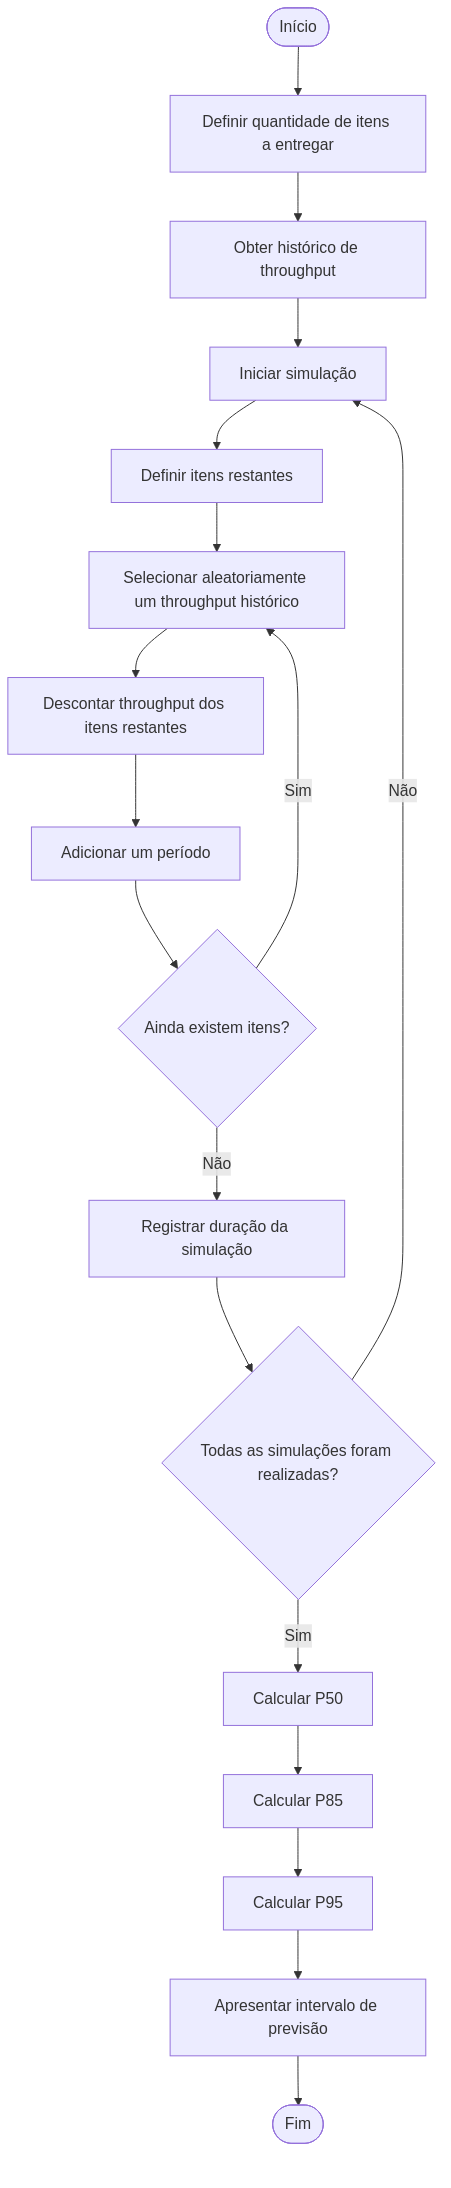
Interpretação
O resultado deve ser comunicado como intervalo probabilístico.
| Percentil | Exemplo de previsão |
|---|---|
| P50 | 5 semanas |
| P85 | 7 semanas |
| P95 | 9 semanas |
A equipe poderia comunicar:
“Há aproximadamente 85% de chance de concluir o escopo em até sete semanas.”
A vantagem é evitar promessas determinísticas baseadas em um único cenário.
5. Guia rápido: de dados a decisões
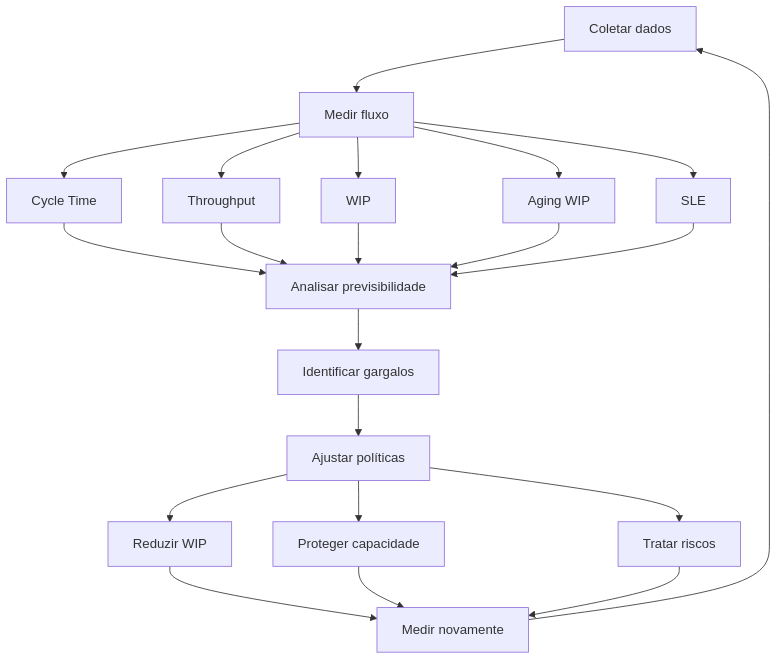
Princípios fundamentais:
- Meça e torne visível o fluxo.
- Acompanhe cycle time, throughput, WIP e aging WIP.
- Utilize SLE baseada em dados.
- Limite WIP.
- Proteja capacidade para itens de risco e qualidade.
- Trate riscos como cidadãos de primeira classe no backlog.
- Utilize percentis para comunicar previsibilidade.
- Utilize Monte Carlo quando houver histórico suficiente.
- Evite promessas determinísticas sem base de dados.
- Revise políticas nas retrospectivas.
6. Recursos práticos
Checklist de higiene de dados
| Verificação | Objetivo |
|---|---|
| Eventos de entrada consistentes | Medir início corretamente |
| Eventos de saída consistentes | Medir conclusão corretamente |
| Bloqueios registrados | Identificar gargalos |
| Itens grandes quebrados | Reduzir variabilidade |
| Movimentações artificiais evitadas | Preservar qualidade dos dados |
| Políticas de fluxo documentadas | Garantir interpretação consistente |
ROAM Board
Aging WIP
A análise de Aging WIP pode seguir o seguinte processo:
Conclusão
Métricas de fluxo fornecem um espelho objetivo do sistema de trabalho. Combinadas a políticas claras de WIP, classes de serviço e SLE, elas permitem aumentar a previsibilidade sem sacrificar qualidade.
A gestão de riscos, por sua vez, reduz incertezas e protege objetivos de valor, prazo e conformidade quando integrada ao backlog e aos ritos do time.
Com dados, cadência e contramedidas visíveis, a equipe consegue melhorar continuamente a eficiência e a confiabilidade de suas entregas.
Próxima aula
Qualidade guiada por critérios: governança de código e testes.
Veremos práticas de revisão, automação de testes, critérios de aceite, pipelines de qualidade e sua relação com a manutenção da previsibilidade e redução de riscos.